一个 Oracle 应用迁出去,要过哪五关
将 Oracle 应用迁移拆解为语法、类型、函数、过程语言、包与系统视图五关,给出自查清单、推荐顺序和验收要点。
李枨
IvorySQL 社区贡献者
作者简介:李枨(GitHub @muzimu217),IvorySQL 社区贡献者。
摘要
把 Oracle 应用迁走,很多人以为就是改语法。真做起来才发现,卡人的是函数、过程和系统视图里的行为差异。本文把迁移拆成五关,逐关看 IvorySQL(Oracle 兼容模式)在每一关上怎么过,并给出迁移前的自查清单和推荐顺序。写给正在规划 Oracle 迁移、需要提前评估兼容深度的团队。这篇讲的是方法,不是结论。
一、迁移是一串关卡
一次 Oracle 迁移,其实是连着过好几关。哪一关卡住,整个迁移就停在哪。按五层兼容拆,正好对应五关:
| 关卡 | 难度 |
|---|---|
| ① 语法关 | 最容易 |
| ② 类型关 | 中等 |
| ③ 函数关 | 最容易藏坑 |
| ④ 过程语言关 | 最难之一 |
| ⑤ 包与系统视图关 | 最难 |
第 ③ 关看着最简单,实际最容易翻车。
这五关的顺序不是随便排的。前面的关卡决定后面的输入:语法过不了,类型就无从谈起;类型映射不对,函数的输出就没有意义。所以迁移要按顺序推,不能跳。
成色说明:这是迁移通关地图,不是完整的实战案例,我没有把一整套 Oracle 生产应用端到端迁过。文中 IvorySQL 侧(Oracle 兼容模式)的函数行为我实测过(UTL_URL 转义、SYS_CONTEXT);每一层能做到哪一步,依据是 IvorySQL 官方文档和仓库里的实现(ivorysql_ora 扩展、PL/iSQL)。
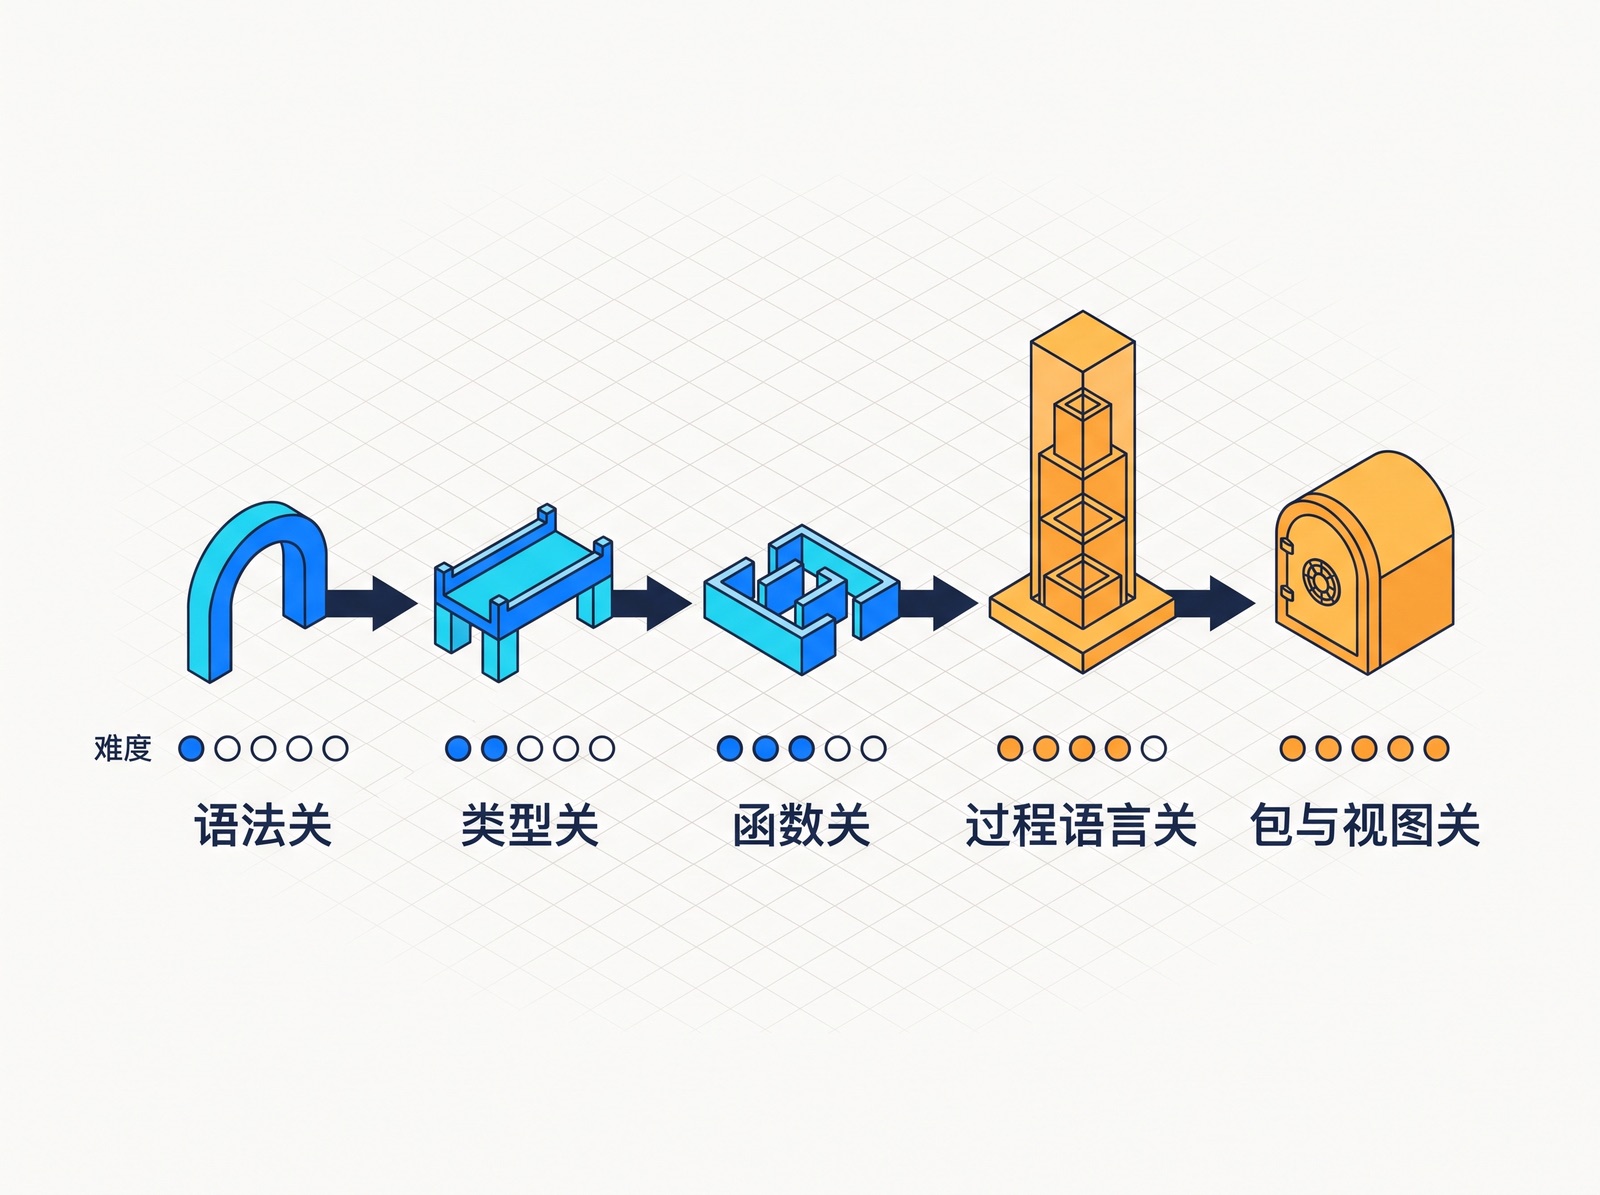
图 1:迁移的五道关,难度逐层递增。
二、五关清单
| 关卡 | 典型问题 | IvorySQL 怎么过 |
|---|---|---|
| ① 语法 | dual、(+) 外连接 | 双 parser,切 compatible_mode=oracle 后由 Oracle 解析器接管 |
| ② 类型 | NUMBER 精度、DATE 时分秒 | ivorysql_ora 做类型映射,精度按边界用例核 |
| ③ 函数 | NVL / TO_DATE / DECODE 的行为细节 | ivorysql_ora 逐个实现,UTL_URL 转义我实测过 |
| ④ 过程语言 | PL/SQL 存储过程、触发器 | PL/iSQL,语法贴近 Oracle PL/SQL |
| ⑤ 包与视图 | PACKAGE、V$ 视图 | PL/iSQL 支持 PACKAGE,ivorysql_ora 补内置包和系统视图 |
这张表最值得看的是「IvorySQL 怎么过」这一列,而不是「典型问题」那一列。问题清单谁都能列,能不能给出对应的实现路径,才决定这次迁移是几天还是几个月。
⚠表中 IvorySQL 一列均指 Oracle 兼容模式。IvorySQL 建库时用 initdb -m oracle(默认)或 initdb -m pg 决定集群形态,PG 模式的集群建库时就定死了,不能再切到 Oracle。在 Oracle 兼容模式里,会话可以用 SET ivorysql.compatible_mode = oracle 切到 Oracle 语法,用 SET ivorysql.compatible_mode = pg 切回原生语法。拿 PG 模式的库去跑 Oracle 语法报错,通常不是兼容没做,而是模式没选对。
⚠这张表说的是 IvorySQL 的实现路径,不是你这次迁移的验收结论。真正要核的是你应用实际用到的那些函数和视图,清单在第五节。
三、函数关里踩过的坑
第 ③ 关最坑,因为语法一样、结果可能不一样。
我补 UTL_URL.ESCAPE 的时候,本来以为照着 Oracle 文档写就行。结果文档自己对不上:19c 的概述页和用法页,保留字符表居然不一样;# 转不转,文档口径在 19c 到 21c 之间还改过。更麻烦的是,运行时行为也不统一——我在 XE 11.2、18c、21c 上测到的是一套结果,PR 讨论里另一套 Oracle 环境又是另一套。
只能真机实测。我在 Oracle XE 11.2、18c、21c 上跑同一段输入,逐行对照,才定出该转哪些。测出来两个结论:
-
% 恒转义,而且已转义的输入会被双重转义(a%20b → a%2520b);
-
在我测的这三套 XE 上,保留字符是 10 个 ;/?:@&=+$,。19c 文档自己就对不上:概述页列 12 个,用法页列 10 个。% 在所有环境里都恒转义,概述页把 % 列进去是错的;# 则随环境变。
这个函数有没有,好查;它的行为跟 Oracle 对不对得上,才要命。迁移时如果只对函数名,不对行为,测试环境是过不去的。
这也是为什么迁移测试不能只写「跑通」的用例。跑通只证明函数存在,证明不了它算得对。真正有用的用例,是同一批输入在 Oracle 和新库上各跑一遍,然后 diff 输出。
注:这里的「对得上」不含刻意偏离 Oracle 的一处(url_charset 省略时的默认编码),PR #1728 里有记录。
这段经历后来成了我看其他兼容点的模板:先查文档,再找文档之间的矛盾,最后用真机把矛盾解开。三步里最花时间的是第三步,但只有第三步的结论能写进代码。
四、行为差异才是大头
| 差异类型 | 好不好发现 | 好不好修 |
|---|---|---|
| 语法差异 | 好发现——编译不过就报错 | 好修 |
| 类型差异 | 中等——精度问题可能很晚才暴露 | 中等 |
| 行为差异 | 难发现——跑得过,结果不对 | 难修——要逐点实测 |
迁移时最贵的,永远是不报错的那部分。报错至少给了你一个位置,行为差异连位置都不给。所以排期时,语法和类型可以按天算,函数和行为差异要按周算。预算给少了,最后一定是在上线前补。判断一个库能不能换 Oracle,别只看「支持哪些语法」,要看「行为对得上几个函数」。
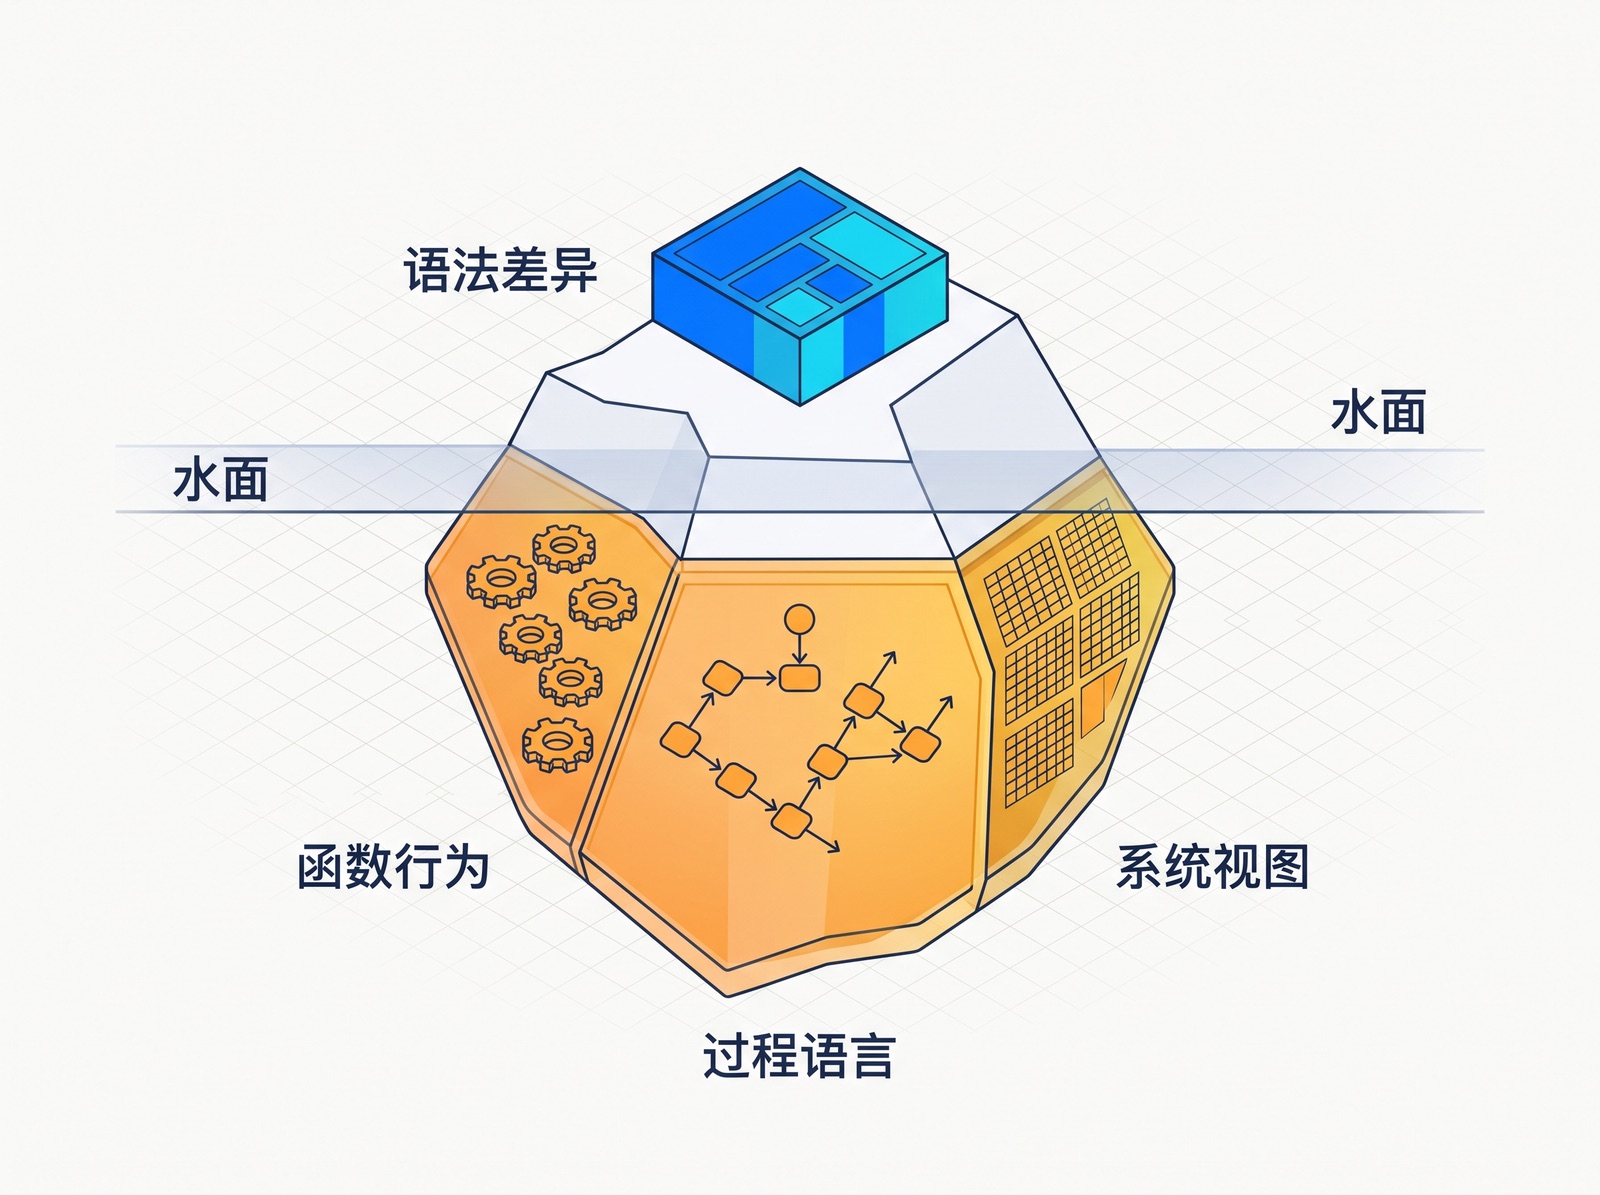
图 2:水面之上是语法差异,水面之下是更庞大的行为差异。
五、迁移前自查清单
| 检查项 | 怎么查 | 通过标准 |
|---|---|---|
| 应用用了哪些 Oracle 函数 | 全文搜 + 导出依赖清单 | 有一张清单,不靠印象 |
| 哪些函数行为跟环境相关 | 对照文档,再实测 | 像 UTL_URL 这种已单列 |
| 有没有 PL/SQL 过程和包 | 看 schema 里的 procedure / package | 有,就把 ④⑤ 关列为主战场 |
| IvorySQL 官方兼容清单拿没拿到 | 查官方文档,或向社区要 | 拿到可核对的表,不是宣传页 |
| 测试用例覆盖行为差异没有 | 看用例是不是只测「跑得通」 | 有「结果对不对」的断言 |
| 回滚方案 | 迁移前备份 + 新旧双跑 | 出事能退回去 |
这份清单建议在迁移启动会上就过一遍,而不是等到测试阶段。前面几项决定工作量,最后一项决定你敢不敢切。
六、推荐迁移顺序
-
先盘点。把函数、类型、过程、包列全。这一步做不完,后面全是补漏。
-
再语法。原 SQL 直接跑,改到不报错。这一步最便宜。
-
再函数。同一批输入两边跑,diff 输出。这一步最花时间。
-
再过程语言。编译、调用、异常分支都得走。
-
最后包与视图。贴着内核,放到最后收尾。
-
全程留回滚。新旧双跑,数据对得上再切。
顺序反了,先改函数、后补语法,等于在流沙上盖房子:语法一变,前面的测试全得重来。
还有一点:每一步都要留下可复跑的用例。迁移不是一次性的动作,后面换版本、打补丁,都要拿这批用例回归。用例攒得越早,后面越省力。
七、迁移最容易踩的五个坑
-
只对函数名,不对行为。名字一样、结果不一样,测试环境若只测「跑得通」就发现不了。函数迁移要同一批输入在 Oracle 和新库各跑一遍,diff 输出。
-
忽略类型精度。
NUMBER的精度和标度、DATE的时分秒,可能很晚才暴露。类型映射表之外,要补边界值和精度用例。 -
把「跑得过」当「迁完了」。编译通过、SQL 能执行只是第一关;业务链路、异常分支、增量逻辑都要回归。
-
把「我测过」当成「到处都一样」。
#就是个例子:它在 URL 里是片段分隔符,不转成%23可能被截断。我在 XE 11.2/18c/21c 上测到它恒转义,PR 讨论里另一套 Oracle 环境默认却放过。这不是说 Oracle 行为没有标准,而是说:兼容性结论必须跑在你自己的目标环境上,不能拿别人的实测结果直接套。 -
拿宣传语当验收标准。「全面兼容」是能力声明,不是你这次迁移的验收条件,验收要看的是你自己的用例。
这五条不是五个独立技术点,而是迁移验收里最常见的五个反模式。共同点是:它们通常不会在“编译通过”时暴露,却容易在测试后期或上线前集中爆出来。
八、迁完怎么验收
| 验收项 | 怎么验 | 不通过就先别切 |
|---|---|---|
| 数据一致性 | 行数、主键范围、关键字段 checksum | 对不上,说明搬漏了 |
| 业务回归 | 跑核心链路,不只跑单条 SQL | 增量逻辑最容易坏 |
| 性能对比 | 同一套压测脚本,新旧各跑一遍 | 慢到不可接受就得回炉 |
| 回滚演练 | 真回滚一次,别只看方案 | 没演练过,出事必慌 |
最后一条最容易被跳过。回滚方案写在文档里不算数,真跑一遍才算。
九、一句实话
先把地图画对,再决定走哪条路。
这篇给的是地图,不是走完全程的报告。地图的价值在于让你知道下一段路有多长,而不是替你走完。真要写成一份完整的迁移案例,得有一个真实的端到端场景。